数据库慢查询定位与优化实战手记
上周凌晨两点被电话炸醒。
是前公司运维的小周,声音都发颤。说大促预演的时候,运营拉30天的订单汇总报表,数据库直接卡到连后台登录都转圈。
我套上外套连了VPN上去,第一反应不是找SQL哪里错了,是先跑show processlist把所有正在跑的会话列出来。
真遇上慢查询,没人能稳得住。
MySQL慢查询日志输出示例截图 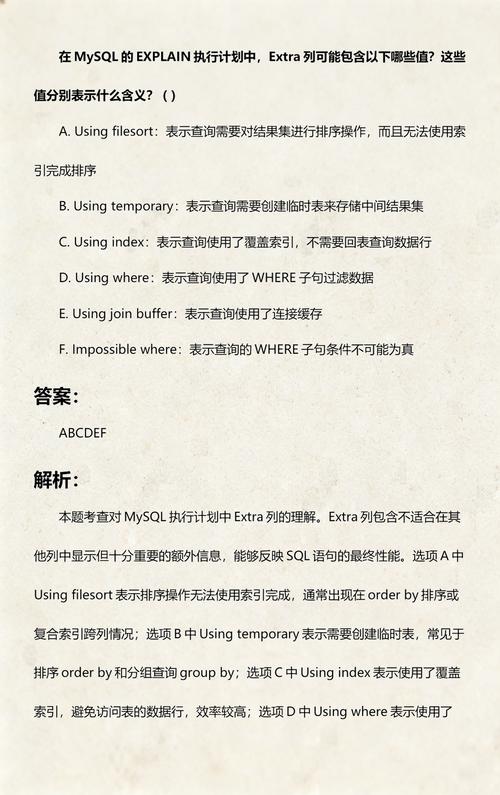
MySQL执行计划Extra字段含义对照表
先别急着改SQL,先把慢的证据抓全
很多人一看到慢查询告警,冲上去就对着SQL改,加where条件,改join顺序,折腾半天发现根本找错了方向。 慢查询定位的第一步永远不是猜,是把执行计划和实际执行耗时拆解开。 我上去先把那个跑了快一分钟的慢查询捞出来,先看它的执行计划。小周在旁边急得挠头,说上周刚给这个表加了三个索引,怎么还慢。 结果执行计划一拉出来,rows字段显示要扫180多万行,Extra里明明白白写着Using temporary; Using filesort。那些看起来“写对了”的SQL,藏着多少坑
把SQL原文拉出来一看,我差点气笑。 开发写的是left join订单表和用户表,本来的逻辑是要保留所有订单记录,哪怕是没关联到有效用户的游客订单。结果他为了筛掉无效的测试用户,把u.status=1的过滤条件写在了where子句里。 这一下直接把left join的逻辑变成了inner join不说,还因为这个条件的位置不对,导致本来能用的联合索引直接失效。