云原生可观测性体系建设一线踩坑实录
上个月半夜两点接朋友电话,他在做的电商平台K8s集群CPU直接飙到92%,十几个人挤在会议室盯了半小时Grafana面板,愣是没找到问题源头。最后是运维小哥翻了俩小时容器日志,才发现是订单服务的灰度版本把数据库连接池占满了。
他说那一瞬间真想把手里的键盘砸了。
钱花了不少,OpenTelemetry接了,Prometheus搭了,链路追踪也上了,怎么出了问题还是跟瞎了一样?
别把买工具当成建体系
很多团队对可观测性的认知,还停留在“把三支柱凑齐就算完事”的阶段。
上次见一个创业团队,采购清单列了一长串,指标、日志、链路追踪的工具全是行业Top的,结果上线三个月,面板上飘着17个同名的api-gateway指标,分不清哪个是测试环境的,哪个是预发的,哪个是生产的。出问题的时候切环境都要切五分钟,更别说定位根因了。
工具是载体,不是体系本身。你连最基础的标签规范都没定,采集上来的数据全是乱的,再贵的工具也给你变不出有用的结论。
就拿链路追踪来说,很多人接了Jaeger就觉得链路打通了。真等出问题的时候点进去看,某个接口延迟从200ms涨到2s,但是对应的日志没有TraceID关联,也没有绑定下游的数据库慢查询记录,整条链路就是个光秃秃的时间线,除了告诉你“这个接口慢了”,啥用没有。当装饰画看都嫌占地方。
先对齐业务再谈技术指标
还是说回那个电商朋友的团队。之前他们的告警规则全是技术维度的:Pod重启超过2次发告警,CPU使用率超过80%发告警,磁盘用量超过70%发告警。
三个月下来,告警通道累计收到1200多条消息。
谁受得了?
最后运维直接把告警通知给关了。直到那次订单接口30%超时,用户打客服电话投诉到老板那里,所有人都还不知道系统出问题了。
你看,纯技术维度的指标,天生就带着“脱离业务”的毛病。Pod重启两次可能就是发布后的正常波动,但是订单接口成功率掉了5%,那是真金白银的损失。
可观测性的告警,从一开始就应该锚定业务价值。把核心交易链路的每一个节点,和对应的业务指标绑定:用户点下单按钮到网关的请求成功率,网关到订单服务的响应延迟,订单服务到库存服务的扣减成功率,一直到最后支付回调的结果,每一个环节的指标都对应明确的业务影响。只要核心链路的成功率低于99.9%,不管技术指标飘不飘,直接触发告警,同时推给对应的开发、运维和业务负责人,不是只把消息扔给运维群就完事。
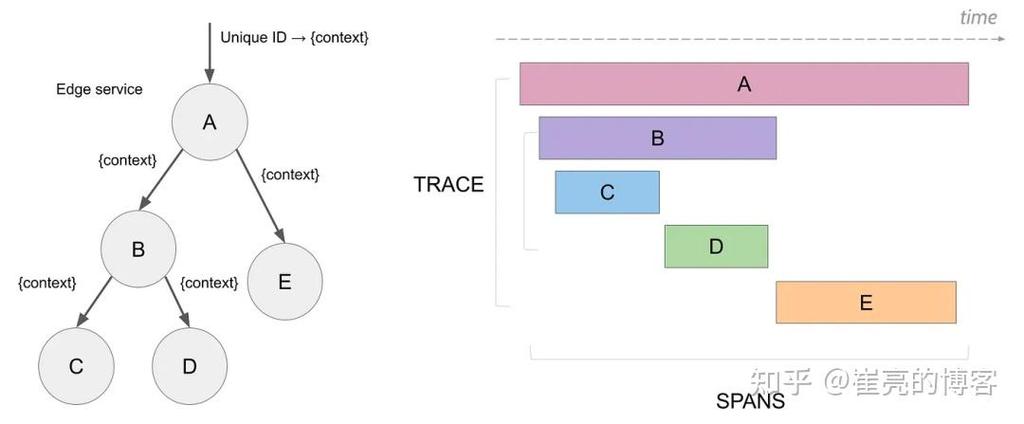
很多人上来就想把所有服务、所有接口的可观测性全做满,结果搞了三个月,一半的指标没人看,光存储成本每个月就大几千。其实根本没必要。先把核心交易链路的观测打通,出问题的时候10分钟内能定位到根因,比你覆盖100个没人用的内部边缘工具有用一百倍。
别把可观测性做成运维的独角戏

我见过太多团队,把可观测性建设的活全压给运维。开发只管写代码,出问题了运维查半天找不到线索,再去找开发对情况,开发还一脸无辜:“我代码里没报错啊,日志都打了‘请求成功’。”
上次碰到个更离谱的开发,写的服务把所有异常都try-catch吞了,日志里只打一句“系统异常”,连堆栈都没留,更别说把TraceID写进日志里了。运维查了三个小时,才发现是下游优惠券服务返回空指针,整个团队熬到早上8点才把问题修完。
这种情况下,你运维团队把面板做的再漂亮,规范定的再细,底层采集上来的数据全是脏的、断的、没有上下文的,体系就是个空架子。
落地的时候得把规则前置到开发环节:所有日志必须带上当前请求的TraceID,关键业务节点要打印订单号、用户ID这类核心参数,服务里的异常不能随便吞,要么打全堆栈,要么抛出去让链路能抓到错误。这些事不是运维天天追在开发屁股后面催的,得写到代码评审的Checklist里,提交代码的时候过一遍,从源头保证采集到的数据是可用的。
之前有个做SaaS的朋友跟我聊,他们团队为了让大家愿意用可观测性的能力,专门把核心链路的成功率、客户请求量这些指标,做成了大屏放在办公区的墙上。每天早会先花两分钟看一眼前一天的指标波动,慢慢的开发也开始主动去查自己服务的性能数据,不再等着出了线上故障才临时抱佛脚。
说白了。
可观测性从来不是给运维团队做的仪表盘。
是整个团队对自己业务运行状态的“体感”。你能随时知道系统在跑什么,哪里出了问题,影响范围有多大,比买多少贵的工具都强。